5 oct 2026
Plataforma de datos para concesionarias en Google Cloud
Pipeline automatizado de Kaggle a BigQuery que convierte ventas de concesionarias en KPIs financieros (utilidad bruta, EBITDA, cumplimiento) para Power BI, desplegado en Google Cloud con infraestructura como código y despliegue continuo.
Problema
En muchas redes de concesionarias, los reportes de desempeño (ventas, utilidad bruta, EBITDA y cumplimiento de objetivos por sucursal) se arman a mano en Excel, tardan semanas en cada cierre y llegan cuando ya no sirven para decidir. Este proyecto construye la alternativa: un flujo automático, reproducible y verificable, de la fuente al tablero, con actualización diaria.
Arquitectura
API de Kaggle ─► raw/ (Parquet por día) ─► curated/ (Parquet) ─► BigQuery ─► Power BI
                 └──────── Cloud Storage ───────┘
Cloud Scheduler (diario) ─► Cloud Run Job ─► ejecuta el pipeline
| Capa | Dónde | Contenido |
|---|---|---|
| Fuente | API de Kaggle | ventas de un dataset público, sin datos personales desde la carga |
raw |
Cloud Storage | ventas validadas, un Parquet por día |
curated |
Cloud Storage | ventas con costo y utilidad bruta, más gastos y objetivos mensuales |
| Warehouse | BigQuery dealer_curated |
tablas tipadas; ventas particionada por fecha |
| Consumo | BigQuery dealer_marts |
dimensiones y vistas de KPIs para Power BI |
Metodología
- Ingesta: descarga desde la API de Kaggle, limpieza y una partición Parquet por día. Incluye backfill por rango de fechas. Los datos personales (nombre, teléfono, género, ingreso) se eliminan al cargar y nunca llegan al lake.
- Curated: costos, gastos y objetivos mensuales simulados con funciones puras, más la utilidad bruta por venta.
- Calidad: validaciones entre capas que detienen el pipeline antes de propagar un lote defectuoso: columnas, nulos, tipos, duplicados, rangos de precio, margen entre 5 % y 25 %, igualdad de filas entre raw y curated y ausencia de datos personales.
- Warehouse (ELT): tablas externas sobre el Parquet, tablas nativas tipadas y vistas de consumo (
dim_concesionaria,dim_fecha,kpi_diario,kpi_mensual). Los KPIs se calculan en SQL, no en Python ni en el reporte:- EBITDA = utilidad bruta − (nómina + renta + marketing + otros gastos)
- Utilidad neta = EBITDA − depreciación − intereses − impuestos
- Power BI: medidas DAX que suman importes y después dividen con
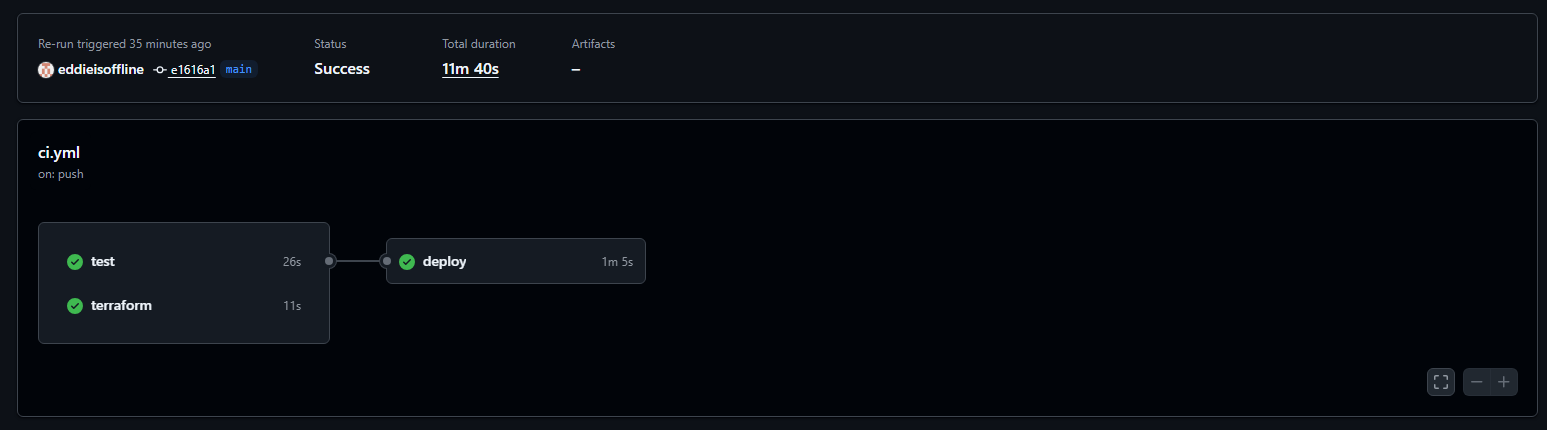
DIVIDE, en lugar de promediar razones. - Operación: Terraform crea el bucket, los datasets, las cuentas de servicio con mínimo privilegio, Secret Manager, Artifact Registry, el Cloud Run Job y Cloud Scheduler. GitHub Actions prueba, valida Terraform y despliega una imagen etiquetada con el SHA de cada commit a
main.
Decisiones de diseño
- Idempotente de punta a punta: cada ejecución sobrescribe su partición y cada sentencia de BigQuery es
CREATE OR REPLACE. Correr dos veces el mismo día no duplica filas. - Simulación reproducible: cada valor sintético sale de un hash de su clave de negocio, no de un generador con estado. El orden o el tamaño del lote no cambian el resultado.
- Mismo código en local y en la nube: el almacenamiento tiene una interfaz común (
LocalStorage/GCSStorage), así las pruebas locales cubren la lógica que corre en GCP. - Sin credenciales en el repositorio: el token de Kaggle vive en Secret Manager y GitHub se autentica en GCP con Workload Identity Federation, limitado a este repositorio y a la rama
main.
Resultados
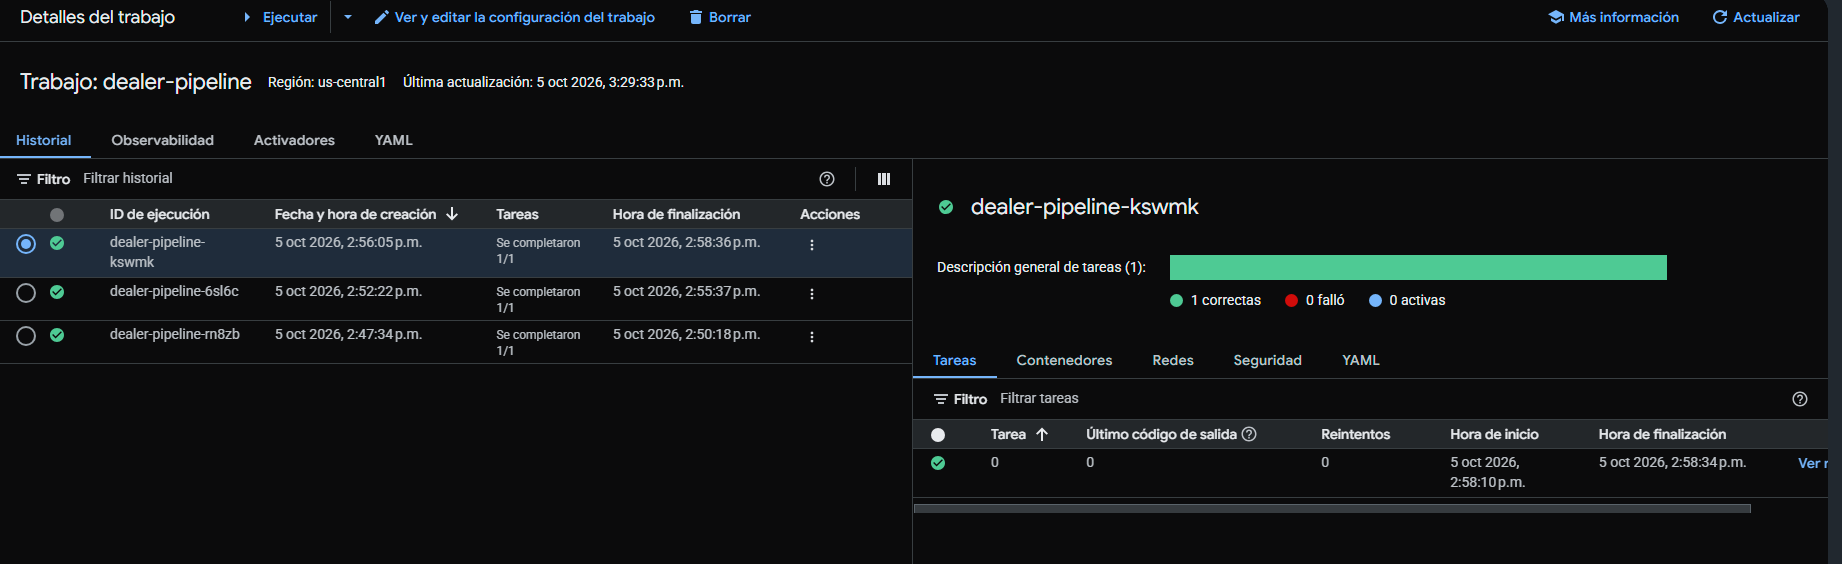
- Carga histórica de 2022 en Cloud Run: 10,645 ventas de 28 concesionarias en 292 días con ventas. Cada paso tarda entre 2 y 3 minutos: backfill 2:12, curate 2:51 y warehouse 2:10.
- Calidad: las validaciones pasaron sin incidencias; raw y curated tienen las mismas 10,645 filas.
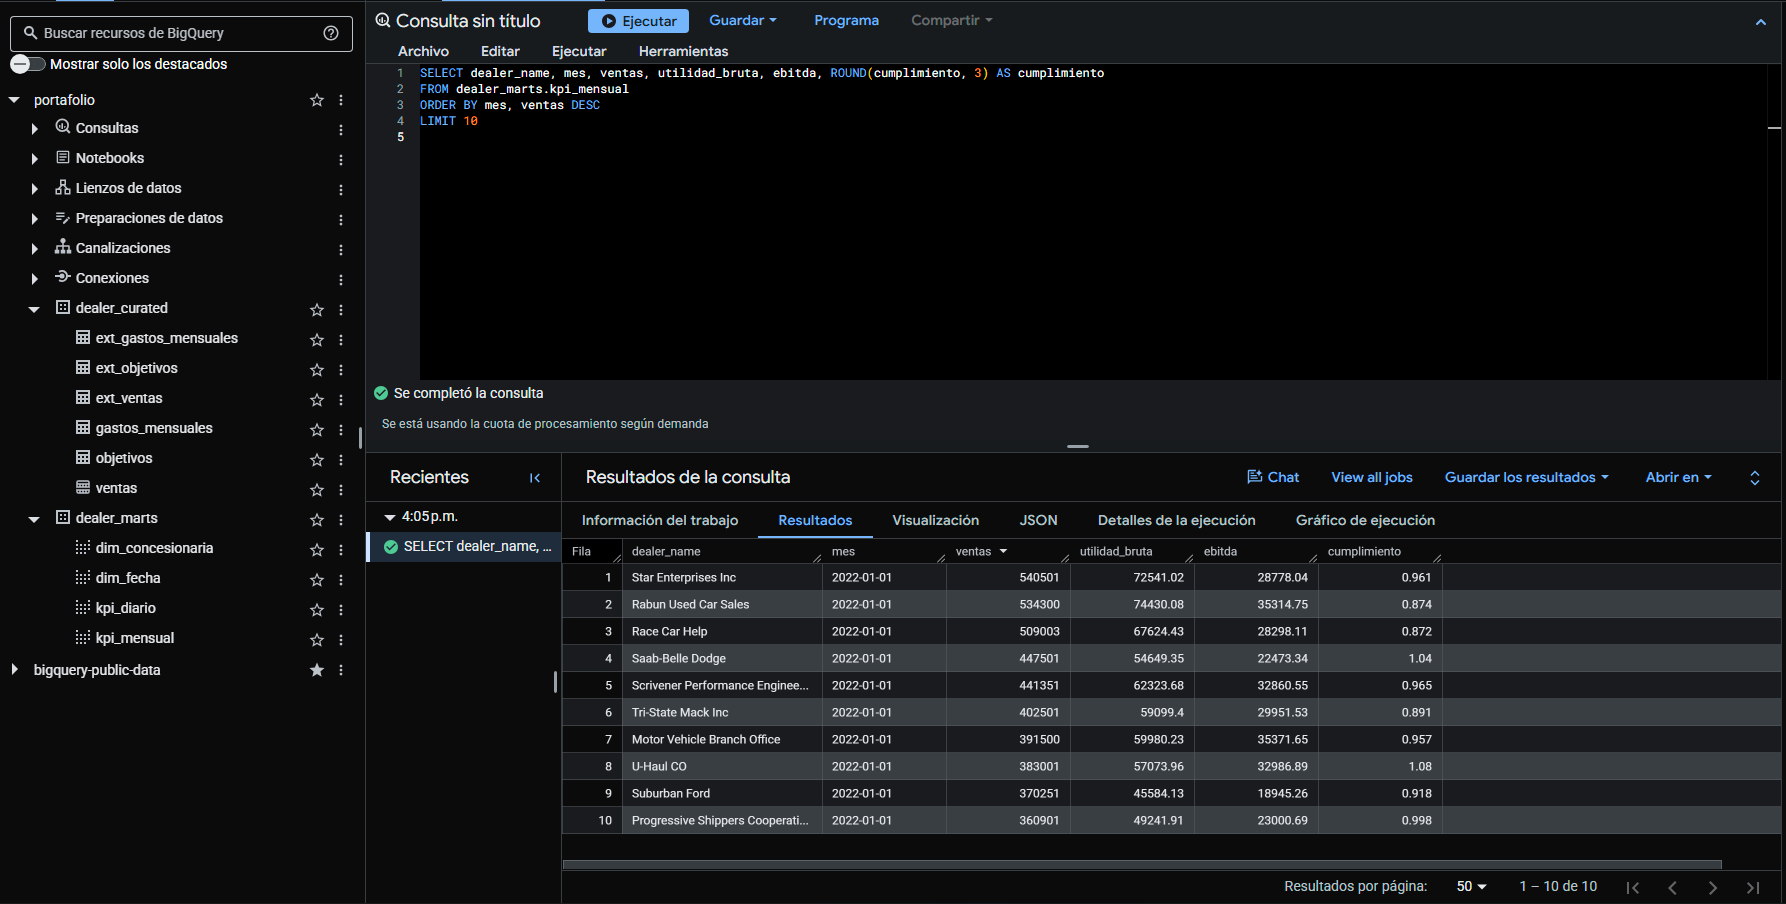
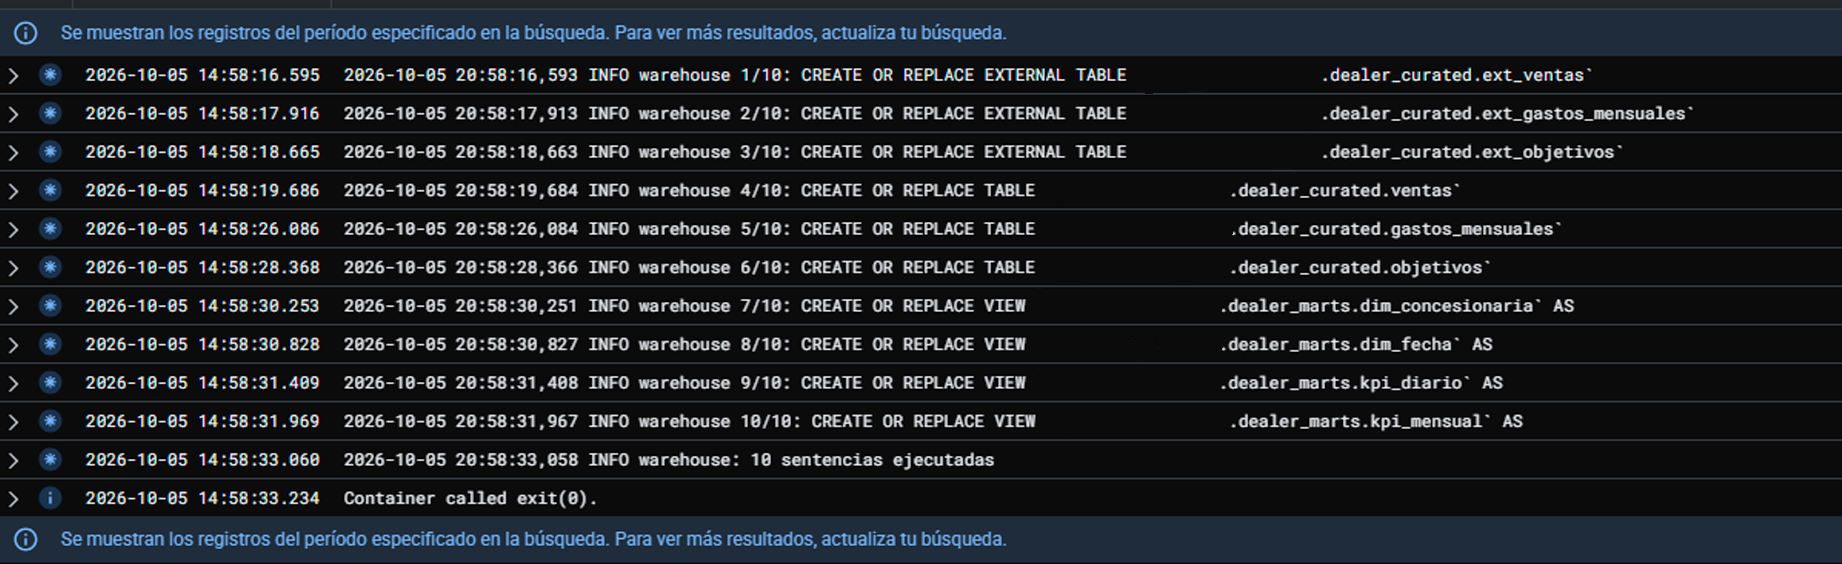
- Warehouse: 6 tablas en
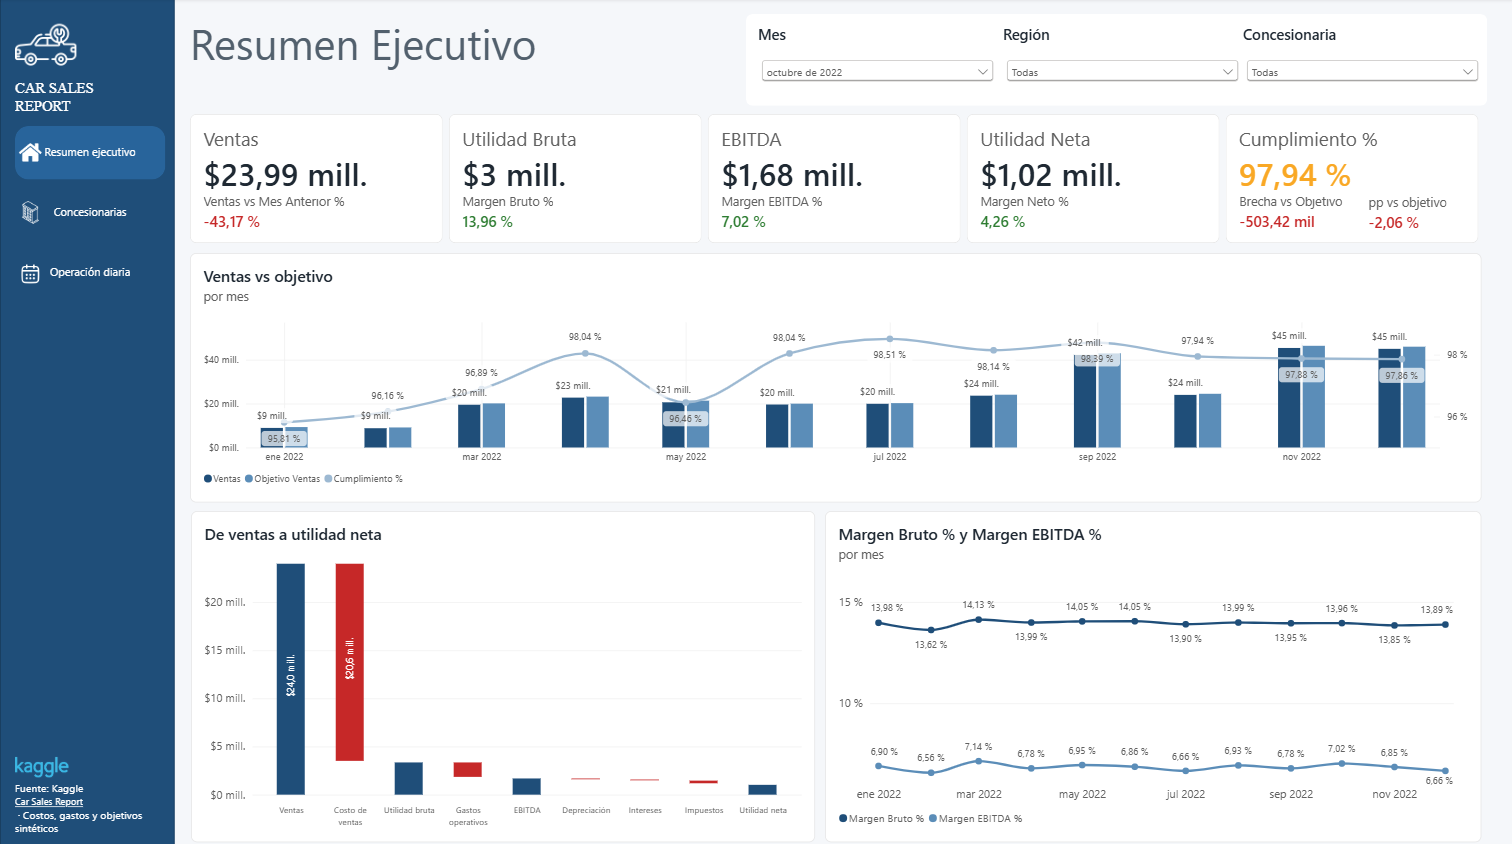
dealer_curatedy 4 vistas endealer_marts, reconstruidas en 10 sentencias SQL. Margen bruto anual de 13.95 % y cumplimiento de objetivos de 97.76 % (cifras sintéticas). - CI/CD: 68 pruebas unitarias sin red ni credenciales; cada push a
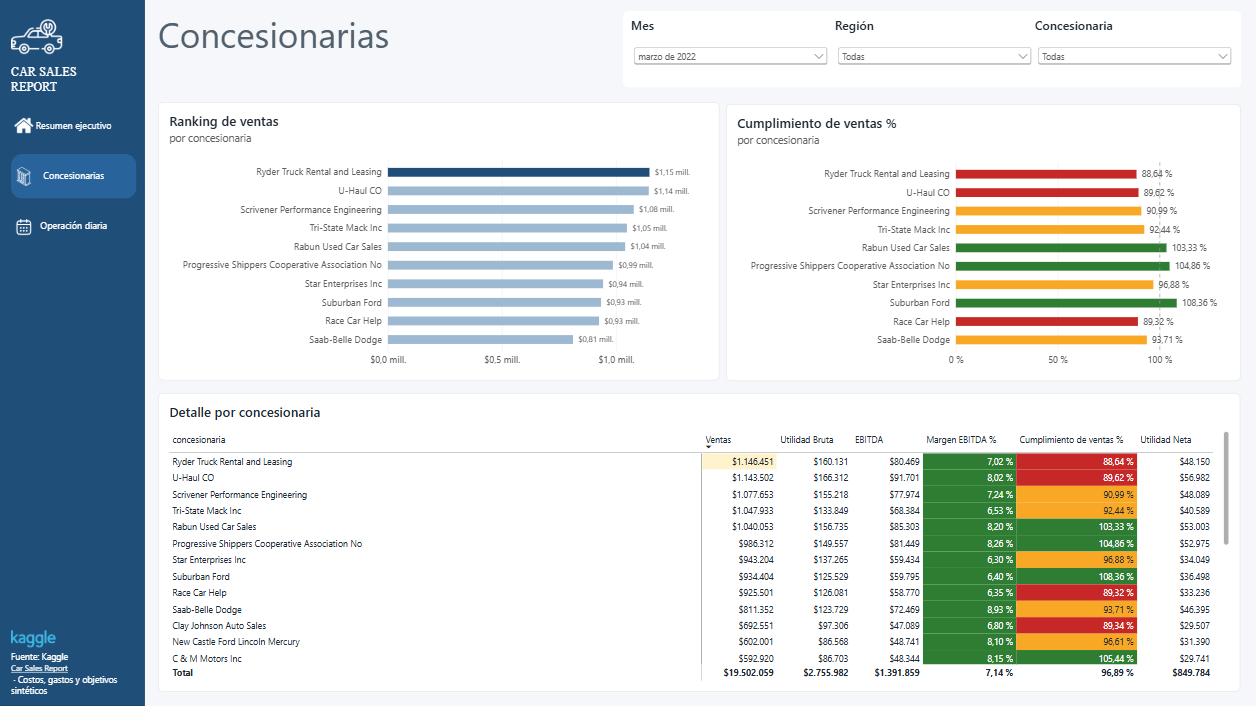
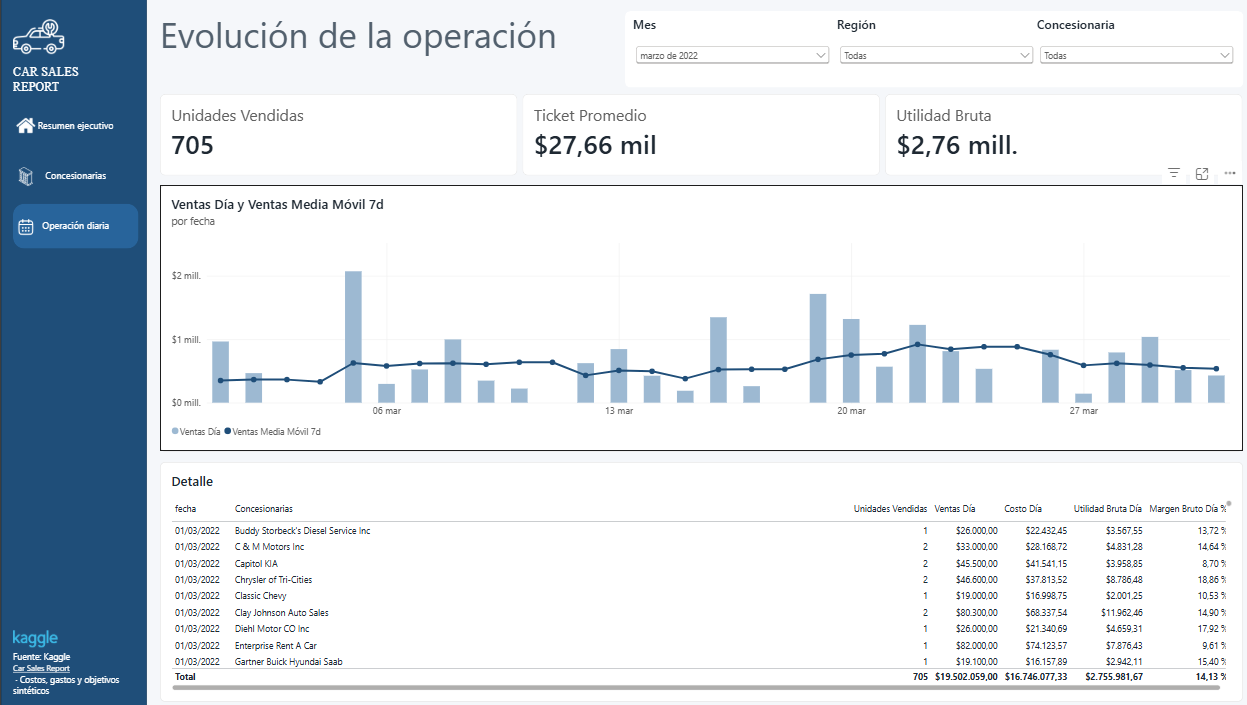
mainprueba, valida Terraform y despliega la nueva imagen en el Cloud Run Job en alrededor de un minuto. - Reporte: Power BI con resumen ejecutivo, comparativo entre concesionarias y operación diaria, conectado a
dealer_marts.
Evidencia en Google Cloud
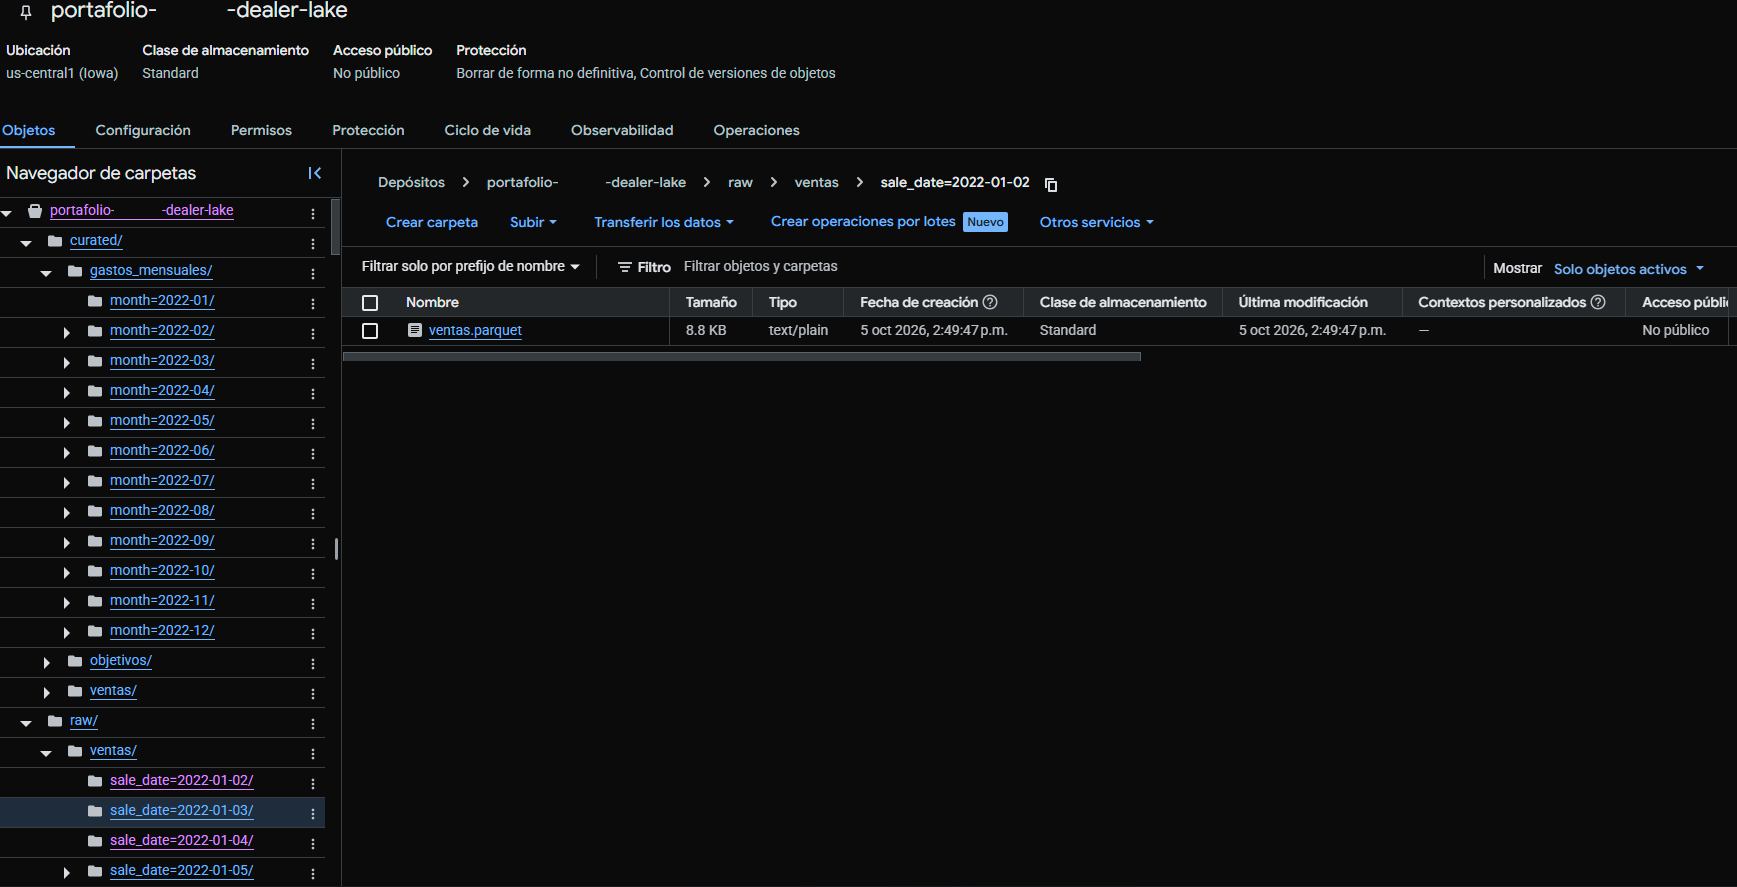
Data lake en Cloud Storage con particiones por día (sale_date=) y por mes (month=):
Tablas y vistas en BigQuery, con una consulta a kpi_mensual:
Ejecuciones del Cloud Run Job y logs del refresco del warehouse:
CI/CD en GitHub Actions:
Stack
Python (pandas, pyarrow) · SQL (BigQuery) · Google Cloud (Cloud Storage, BigQuery, Cloud Run Jobs, Cloud Scheduler, Secret Manager, Artifact Registry) · Terraform · Docker · GitHub Actions · Power BI
Datos
La fuente es el dataset público Car Sales Report de Kaggle, que es estático. Las cargas incrementales se simulan reproduciendo un día del calendario por ejecución. Costos, gastos y objetivos son sintéticos (semilla fija) y no representan datos reales de ninguna empresa.
Documentación técnica: arquitectura y decisiones, warehouse y Power BI y despliegue en Google Cloud.