Problema
Cada mes, el INEGI publica las ventas, la producción y la exportación de vehículos ligeros en México por marca y modelo. Son datos vivos: cada publicación trae el mes nuevo y además puede corregir meses anteriores. Por ejemplo, las ventas de mayo de 2025 se difundieron con 119,959 unidades y hoy aparecen con 121,110. Un análisis que solo descarga “la última versión” no ve esas correcciones y no puede explicar por qué cambió una cifra.
La pregunta del proyecto es cómo evolucionan las ventas por marca, qué tan estacionales son y cuánto las explica el tipo de cambio. El proyecto incluye un pronóstico a 3–6 meses que solo se reporta si le gana a un modelo ingenuo estacional en backtesting.
Estado
Esta página solo describe lo que ya se ejecutó con datos reales.
| Etapa | Estado |
|---|---|
| Ingesta de cada publicación a raw como foto inmutable | Hecho |
| Detector de publicación nueva y descarga | Hecho |
| Capa curated en Parquet (tipos, normalización, duplicados) | Hecho |
| Contratos de datos que detienen un lote defectuoso | Hecho |
| Conciliación contra la API del INEGI y tipo de cambio de Banxico | Hecho |
| Comparación entre publicaciones (qué se revisó y por qué) | Hecho |
| Warehouse en BigQuery y marts | Hecho |
| Pronóstico con backtesting contra baseline | Hecho |
| Dashboard en Looker Studio | Hecho |
| Ejecución programada en Google Cloud | Hecho |
Arquitectura
INEGI (4 zips mensuales) ─► raw/ (una foto por publicación) ─► curated/ (Parquet) ─► BigQuery ─► Looker Studio
API del INEGI + Banxico ─► conciliación y tipo de cambio ──────────┘
curated/ ─► diff entre publicaciones y pronóstico ─► BigQuery
Cada publicación se guarda tal como llegó, con un manifiesto que incluye el sha256 del zip y el de cada archivo; después se convierte en Parquet tipado, se valida, se concilia contra la API del INEGI y se compara con la publicación anterior. El lake vive en una carpeta local o en Cloud Storage con el mismo código, y el warehouse es SQL de BigQuery que también corre en DuckDB sobre el lake local.
Dashboard
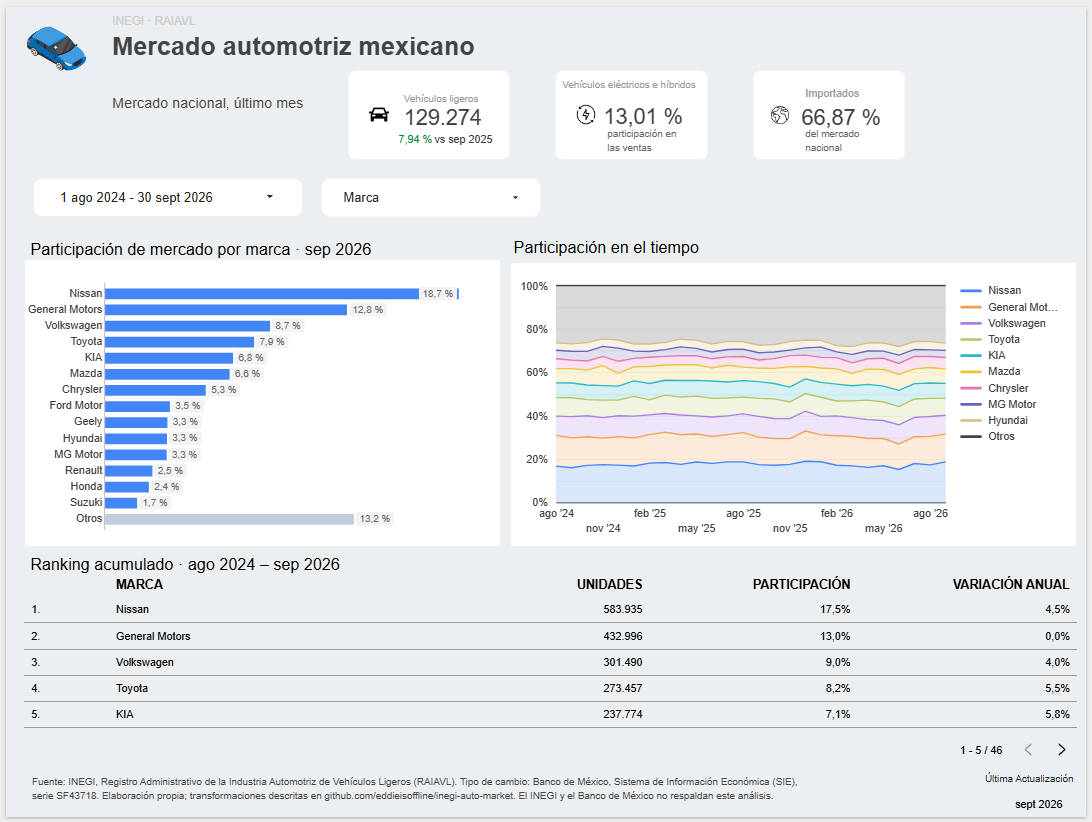
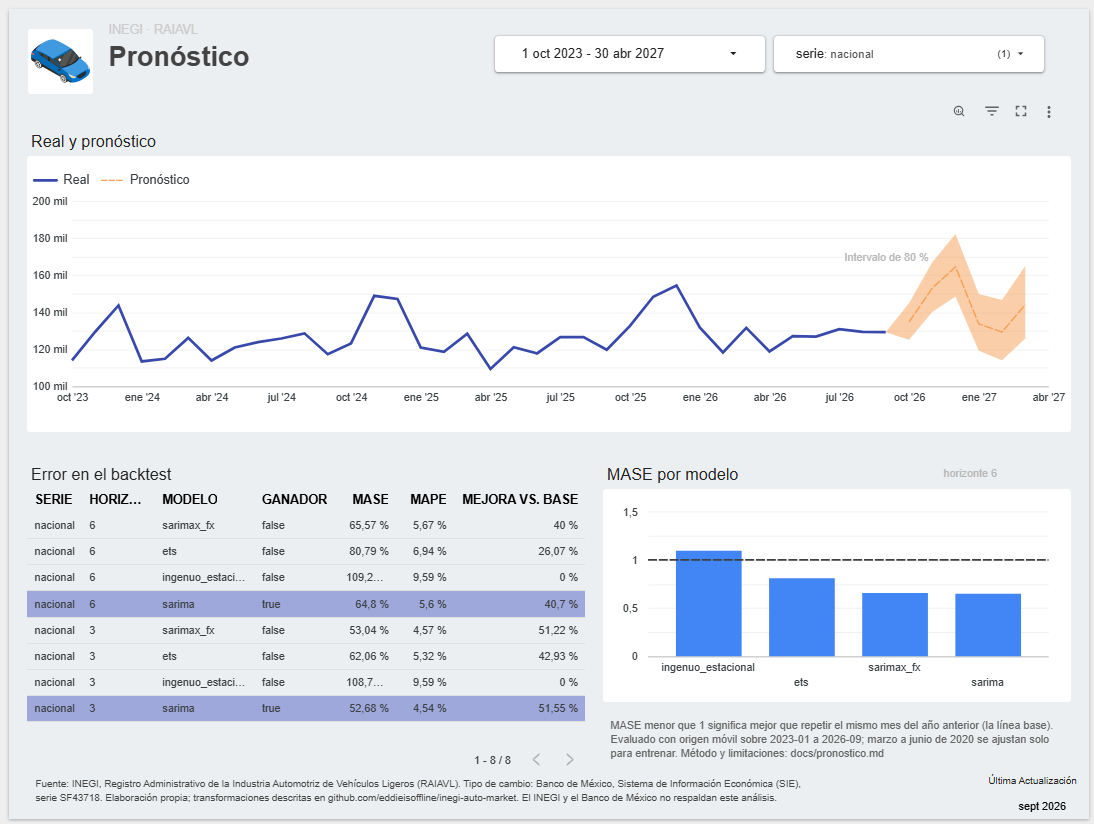
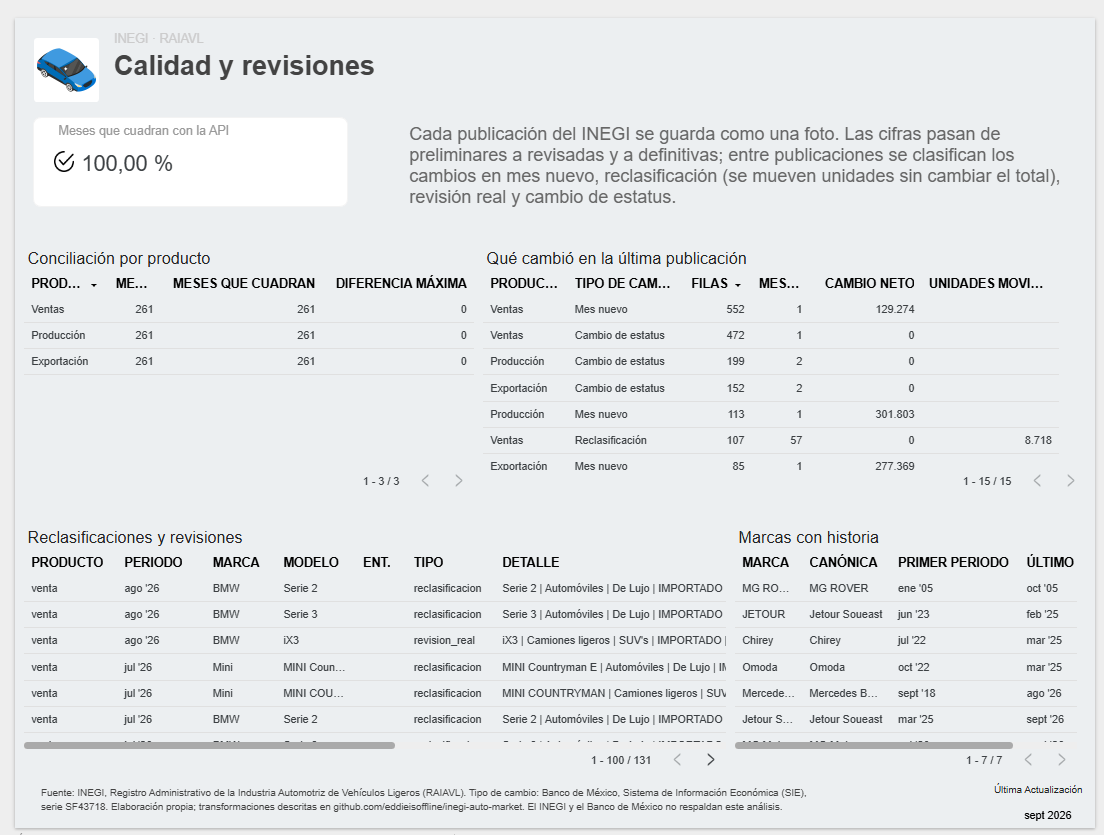
Dashboard en Looker Studio: seis páginas sobre los marts de BigQuery (mercado, tendencia y estacionalidad, producción y exportación, híbridos y eléctricos, pronóstico, y calidad y revisiones).
Lo que ya funciona
- Detección y descarga de publicaciones nuevas: los zips tienen URL fija, así que un GET de un solo byte por producto (
Range: bytes=0-0) basta para saber si cambió algo, sin descargar. No se usa HEAD porque el balanceador del INEGI lo contesta con una página HTML sin cabeceras de versión. Contra el servidor real del INEGI, la primera ejecución descargó los 4 zips (69 MB) en 141 s, idénticos byte a byte a los bajados a mano. Las siguientes ejecuciones no descargan nada y tardan alrededor de un segundo. Los errores de red se reintentan con espera. Si hay publicación nueva pero la descarga falla, el comando termina con error y dice cómo subir el zip a mano. - Ingesta de fotos: el producto y la fecha de publicación se leen del contenido del zip, no del nombre del archivo. Antes de guardar se verifica la integridad (CRC) y la estructura del zip. Ingerir las dos publicaciones reales (8 zips, 69 MB) tarda alrededor de un segundo, y la segunda ejecución no escribe nada.
- Nunca se sobrescribe una foto. Si llega otro zip con la misma fecha de publicación, se comparan los archivos por dentro:
- si es el mismo contenido con otro empaquetado, no se escribe nada y se avisa;
- si es una corrección silenciosa, la ingesta se detiene y lista los archivos que cambiaron.
- Capa curated: cada foto se convierte en Parquet tipado. Se recortan espacios, se agregan el modelo sin el guion final y una clave en minúsculas, y se suman las filas que la fuente repite; cada fila conserva su estatus y la fecha de la publicación. Las dos publicaciones reales dan 640,889 filas en 162 archivos (4.7 MB). Los totales mensuales cuadran con la suma directa de los CSV en todos los meses de las 8 fotos, y con las cifras oficiales anotadas (por ejemplo, ventas de septiembre de 2026: 129,274). Volver a curar tarda 7.6 s y deja los archivos idénticos byte a byte.
- Contratos de datos: antes de escribir cada foto en curated se revisan columnas, tipos, claves, estatus, continuidad de los meses contra el periodo que declara el propio INEGI, códigos contra sus catálogos y que no desaparezca una marca grande de ventas. Un error detiene el lote sin escribir nada; las advertencias quedan registradas. Para calibrar los umbrales, las reglas se aplicaron como si cada mes desde 2006 hubiera sido el último publicado: en 249 meses de ventas habrían frenado un solo lote (abril de 2025, cuando Chirey, con 1.24 % del mercado, dejó de reportar), y en exportación habrían dejado dos advertencias. Las dos publicaciones reales pasan sin advertencias.
- Conciliación contra la API del INEGI: los totales mensuales de curated se comparan con los totales nacionales del Banco de Indicadores, con tolerancia cero en producción y exportación y de ±0.01 % en ventas; el resultado de cada mes queda guardado. Contra la API real, los 261 meses de la publicación de octubre (2005-01 a 2026-09) cuadran exacto en los tres productos. En la de septiembre, la única diferencia en toda la historia es agosto de 2026 en ventas: 1 unidad (0.0008 %), una revisión que la API ya traía.
- Tipo de cambio: la serie FIX de Banxico desde 2005 (5,477 días) se guarda por día y, por mes, como promedio y como dato del último día hábil.
- Comparación entre publicaciones: el comando
diffcompara dos fotos al grano de marca y modelo normalizado y clasifica cada cambio como mes nuevo, reclasificación (las unidades se mueven sin cambiar el total), revisión real (cambia el total) o cambio de estatus. Entre septiembre y octubre de 2026 encuentra la reclasificación de BMW, una sola revisión real en toda la historia (−1 unidad) y, en híbridos, 74 unidades que pasaron de híbridas a plug-in en 23 estados sin cambiar el total. Tarda menos de 3 segundos. - Warehouse y marts: el modelo analítico está escrito en SQL de BigQuery (tablas externas, hechos particionados por mes, dimensiones y 15 vistas para el dashboard). Está aplicado en BigQuery sobre el lake en Cloud Storage, con los hechos particionados por mes. El mismo SQL también se traduce con sqlglot y corre en DuckDB sobre el lake local, lo que permitió verificarlo con datos reales antes de subirlo: en las dos versiones, los marts reproducen las cifras oficiales y dan exactamente lo mismo. La dimensión de marcas une a JETOUR y Jetour Soueast en una sola serie.
- Pronóstico con backtesting: cuatro modelos (ingenuo estacional como línea base obligatoria, ETS, SARIMA y SARIMAX con el tipo de cambio rezagado 6 meses) se evalúan con origen móvil: cada pronóstico usa solo los datos que existían en su origen, sobre los 45 meses de 2023 a septiembre de 2026. La caída de marzo a junio de 2020 se trata de forma explícita y se mide su efecto.
- Ejecución diaria en Google Cloud: un Cloud Run Job, disparado cada día por Cloud Scheduler, pregunta al INEGI si hay algo nuevo y, si lo hay, corre el ciclo completo sobre el lake en Cloud Storage y refresca BigQuery. Desde la nube, los 4 zips llegaron idénticos byte a byte a los descargados a mano, y el ciclo completo de la publicación de octubre tardó 7 min 27 s. La última publicación procesada se registra solo al terminar: cuando una ejecución falló a mitad del ciclo, la siguiente la retomó sin volver a descargar. La infraestructura está en Terraform, con cuentas de servicio de mínimo privilegio, los tokens en Secret Manager, una alerta por correo cuando una ejecución falla y despliegue por SHA desde GitHub Actions con Workload Identity Federation, sin llaves guardadas.
- Pruebas sin red: 247 pruebas corren en GitHub Actions en cada push. Usan fixtures de 71 KB recortados de las publicaciones reales, sin cambiar ningún valor. Los fixtures incluyen a propósito los casos difíciles: claves duplicadas, correcciones negativas, una marca que cambia de nombre y la reclasificación de BMW. El servidor del INEGI se simula, incluidos 403, cortes de red, descargas incompletas y réplicas con cabeceras distintas.
Hallazgos sobre la fuente
Medidos al comparar dos publicaciones reales (septiembre y octubre de 2026). Las revisiones y reclasificaciones las calcula el propio pipeline con el comando diff.
- Las cifras se revisan entre publicaciones. En octubre, BMW movió unidades de “Serie 2” y “Serie 3” importados a modelos nacionales nuevos (“Serie 2-”, “Serie 3-”) desde diciembre de 2021. Por ejemplo, en agosto de 2026 la Serie 2 importada pasó de 157 a 50 unidades y aparecieron 107 en la versión nacional. En total, 8,717 unidades de BMW cambiaron de clave en 105 combinaciones de mes y modelo, y el total histórico de ventas solo cambió en 1 unidad (BMW iX3, agosto de 2026). La misma publicación movió 1 unidad de Mini entre dos versiones del Countryman en julio de 2026.
- La revisión de octubre tocó solo los años 2021–2026. En ventas, los archivos de 2005 a 2020 llegaron idénticos byte a byte.
- Las cifras pasan a definitivas un mes a la vez. En octubre solo septiembre de 2023 pasó de revisadas a definitivas, en los cuatro productos. La nota oficial dice que el cambio ocurre en febrero de cada año. Hipótesis: una ventana móvil de 36 meses.
- El empaquetado cambia sin aviso. Los zips de octubre llegaron sin comprimir y pesan entre 12 y 34 veces más según el producto, con las mismas columnas. Por eso la ingesta compara contenido y no solo bytes.
- El servidor tiene réplicas que no coinciden en sus cabeceras. El mismo archivo llega con un
ETagdistinto y unLast-Modifiedque varía hasta 4 segundos según la réplica que conteste (medido el 8 de octubre de 2026). Comparar las cabeceras tal cual hacía creer que había una publicación nueva casi en cada consulta. Ahora una publicación es nueva solo siLast-Modifiedse mueve más de 10 minutos. - Calidad de origen: claves repetidas (137 en ventas, 0.11 % de las unidades), correcciones con unidades negativas (87 filas en ventas, la mayor de −791) y marcas que cambian de nombre (JETOUR pasa a “Jetour Soueast” en marzo de 2025).
Lo que dicen los datos
Con la publicación de octubre de 2026 (2005-01 a 2026-09).
- El mercado se recuperó. En 2025 se vendieron 1.52 millones de vehículos ligeros, 16 % más que en 2019; el récord sigue siendo 2016 (1.61 millones) y el piso, 2020 (0.95 millones). De enero a septiembre de 2026 las ventas van 5 % arriba del mismo periodo de 2025.
- China ya es el segundo origen de lo que se vende. Los vehículos hechos en China pasaron de 0 % de las ventas en 2016 a 20 % en 2025 y 23 % en 2026, solo detrás de los hechos en México. Ganan mercado marcas nuevas o recientes (Geely, de 0 % a 2.9 % en cinco años; MG Motor, de 1.0 % a 3.4 %), mientras Nissan, que sigue liderando, baja de 20.5 % a 17.4 %.
- Dos de cada tres autos vendidos son importados, aunque México produce 2.6 veces lo que vende: en 2025 produjo 3.95 millones y exportó el 86 %, sobre todo a Estados Unidos (78 %).
- La electrificación se acelera. Eléctricos, híbridos e híbridos plug-in pasaron de 0.5 % de las ventas en 2016 a 9.6 % en 2025 y 12.8 % en 2026.
- Las SUV dominan. Pasaron de 18 % de las ventas en 2010 a 39 % en 2025.
- Diciembre es el mes fuerte: vende 33 % más que un mes promedio; abril, 13 % menos.
- El tipo de cambio explica poco. La correlación entre la variación anual de las ventas y la del tipo de cambio es débil (−0.22 en el mismo mes, +0.03 con 12 meses de rezago), y agregarlo al pronóstico solo ayuda en algunas marcas.
- El pronóstico le gana a repetir el año anterior. Para las ventas nacionales, SARIMA reduce el error del ingenuo estacional a la mitad a 1–3 meses (error medio de 4.5 %) y en 41 % a 1–6 meses. En las cinco marcas grandes el mejor modelo también gana, aunque no siempre es el mismo.
Decisiones de diseño
- Cada publicación es una foto inmutable, identificada por la fecha
modifiedde sus metadatos. El historial de revisiones solo existe desde la primera foto guardada, y no se simulan revisiones pasadas. - Se distingue un reempaquetado de una corrección real: la comparación es por archivo, así que regenerar el zip con los mismos datos no detiene el pipeline, pero una corrección silenciosa sí.
- Los duplicados se suman por el nombre original del modelo. En la fuente conviven, en el mismo mes y con el mismo origen, nombres con y sin guion final (por ejemplo, “Tacoma” y “Tacoma-”). Si la suma usara el nombre normalizado, se fusionarían 113 claves de ventas que el INEGI reporta por separado. El nombre normalizado queda como columna aparte para agregar después.
- Detectar sin descargar y sin confiar en un solo dato: el GET de un byte decide con
Last-Modifiedy una tolerancia, y si aun así se descarga una versión que ya estaba, la ingesta la reconoce por sha256 y no escribe nada. El estado de lo descargado solo se actualiza después de ingerir, así que una falla se reintenta en la siguiente ejecución. - El mismo código corre en local y en la nube: el almacenamiento tiene una interfaz común (
LocalStorage/GCSStorage). - Sin credenciales en el repositorio: los tokens del INEGI y de Banxico solo viven en variables de entorno.
Stack
Python (pandas, pyarrow, statsmodels), Parquet, APIs del INEGI y de Banxico, SQL en BigQuery (también en DuckDB con sqlglot), Cloud Storage, Looker Studio, Cloud Run Jobs, Cloud Scheduler, Secret Manager, Terraform, Docker, pytest, ruff, GitHub Actions.
Datos
Fuente: INEGI, Registro Administrativo de la Industria Automotriz de Vehículos Ligeros (RAIAVL), datos abiertos usados bajo los términos de libre uso del INEGI. Este proyecto es independiente: el INEGI no lo respalda ni lo revisa. La capa raw guarda los zips tal como se publicaron. La capa curated fija tipos, recorta espacios, agrega el modelo normalizado y suma las filas repetidas (0.110 % de las unidades de ventas); no cambia ningún valor de unidades. Tipo de cambio: Banco de México, Sistema de Información Económica (SIE), serie SF43718 (FIX).
Documentación técnica: README del repositorio, arquitectura, operación, reglas de la capa curated, contratos de datos, warehouse y marts, pronóstico y fixtures de prueba y sus casos.
- Fecha
- 14 oct 2026
- Herramientas
- Python, pandas, statsmodels, SQL, BigQuery, Looker Studio, Cloud Storage, DuckDB, Cloud Run, Terraform, Docker, pytest, GitHub Actions
- Enlaces
- Repo